
SadTalker
github.com又名 SadTalker
西安交通大学等机构开源的音频驱动视频生成工具,用一张正面人像照片和一段音频合成嘴型同步的说话视频,适合需自行配置 Python 环境与模型权重的开发者本地部署。
工具免费不用登录Linux · Windows英文开源国内不可直接访问
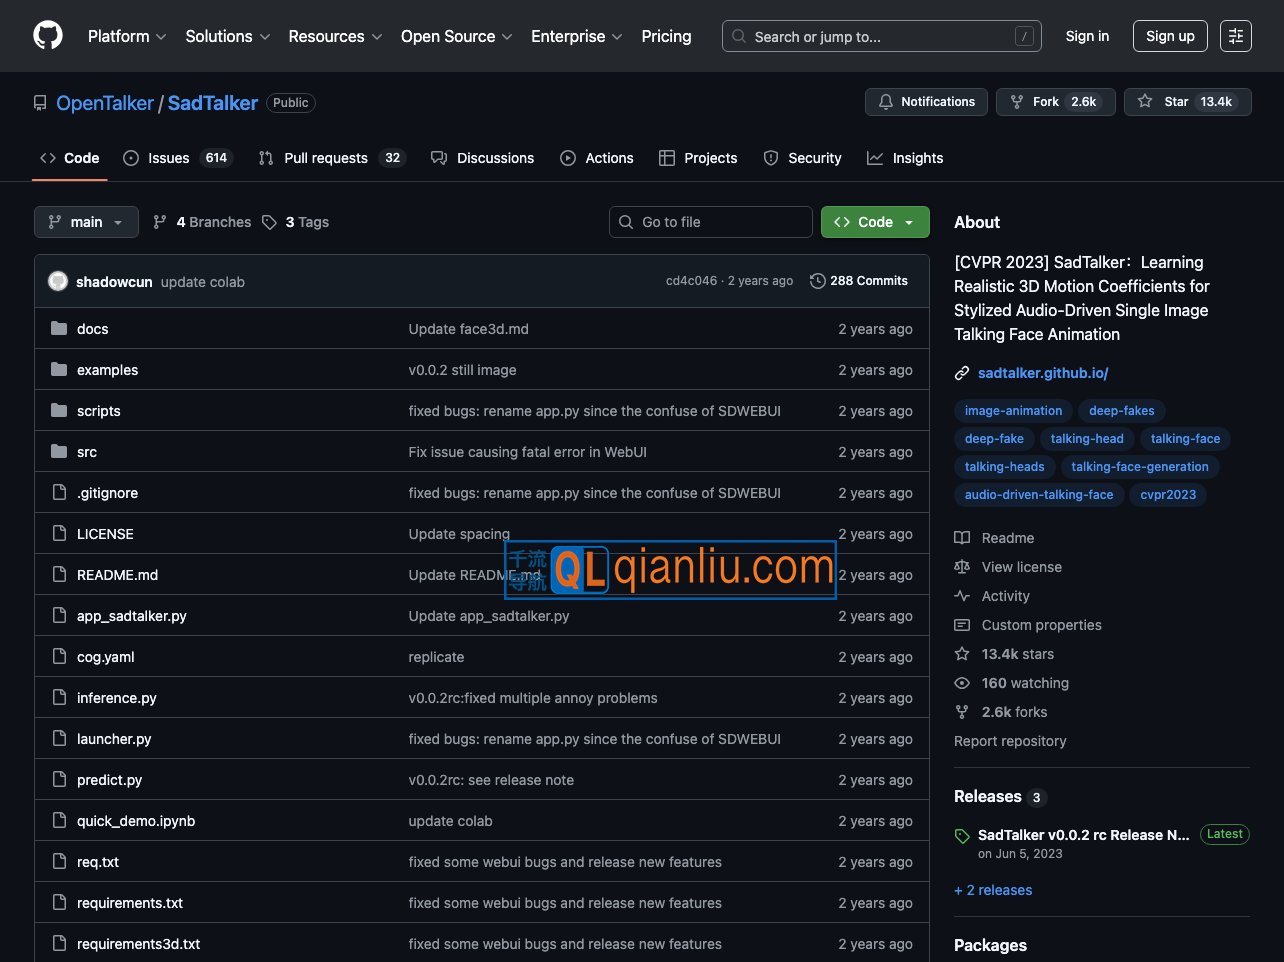
SadTalker 是西安交通大学、腾讯 AI Lab 和蚂蚁集团合作在 CVPR 2023 发表的一个开源项目,代码托管在 GitHub。它要做的事很直接:给一张正面人像照片,再给一段音频,就能生成一段嘴型跟着音频动起来的说话视频。对做虚拟主播、教学课件或者单纯想玩一下的人来说,它提供了一条不用真人出镜就能产出说话画面的路径。
主要功能
项目支持多种模式,包括静态模式、参考模式和缩放模式,还提供全图模式,可以让整张图片动起来而不只是头部。生成时可以选择是否叠加增强器来提升画质。除了命令行推理,它还附带一个 Gradio 网页界面,也发布了 stable-diffusion-webui 扩展,习惯在 WebUI 里操作的人可以直接调用。官方还提到模型已经接入 Discord,可以通过发送文件免费使用。
适合谁
适合有一定动手能力的开发者和研究者:需要自己配环境、下载模型权重、跑推理脚本。普通用户如果不想折腾,可以走 Discord 或 Colab 笔记本这类现成入口,但体验和本地部署会有差别。
费用与限制
代码采用 Apache 2.0 许可,移除了非商业限制,可以免费使用和修改。不过它本身不是开箱即用的在线服务,安装依赖 Python、PyTorch、ffmpeg 等环境,对显卡也有要求。生成效果受输入照片角度、光照和音频质量影响,复杂姿态或侧脸可能不理想。项目页面语言为英文,中文教程由社区提供。
常见问题
SadTalker 收费吗?
SadTalker 免费使用。Apache 2.0 许可,免费使用。
用 SadTalker 要登录吗?
不用登录就能用。
SadTalker 国内能访问吗?
本站 11 月 8 日 检测,SadTalker 在国内不能直接访问,可以看看国内可直接用的替代品:AniPortrait、Hallo、EchoMimic。
SadTalker 有哪些平台 / App?
支持 Linux、Windows。
SadTalker 的替代品有哪些?
本站整理了 6 个替代品,例如 AniPortrait、Hallo、EchoMimic、DreamTalk。
替代品 全部 6 个 →
 AniPortrait
腾讯游戏智迹团队开源的肖像动画框架,用一张人像照片加一段音频生成口型对齐的说话视频,也能把视频里的表情动作迁移到肖像上做面部重演,适合愿意手动下载权重、配置 CUDA 环境的开发者与研究者本地部署。同为照片加音频生成口型同步视频的开源框架,还能迁移视频表情动作,本地部署方式相近
 Hallo
复旦大学等机构联合开源的音频驱动人像动画工具,输入一张人像照片和一段音频即可生成嘴形、表情与头部动作同步的说话视频,代码与模型权重以 MIT 协议开放,适合有 Ubuntu + CUDA 环境的研究生和算法工程师在本地配环境跑推理。复旦开源,一张照片加音频生成嘴形、表情与头部动作同步视频,同样面向开发者本地跑
E
EchoMimic
蚂蚁集团支付宝终端技术部开源的肖像动画生成项目,可用音频、面部关键点或两者结合驱动静态人像生成口型与表情同步的视频,需自行配置环境、下载权重再推理,适合能跑模型的研究者与开发者。蚂蚁开源肖像动画,音频或关键点驱动静态人像,同样需自配环境,功能覆盖相近
D
DreamTalk
开源扩散模型说话头生成框架,由清华大学、阿里巴巴集团与华中科技大学提出,输入一张照片和一段音频即可生成口型同步、表情自然的说话视频,支持多语种与说话风格调节,需自行配置环境与权重,适合数字人方向研究者复现或在此基础上改模型。清华等开源扩散说话头框架,照片加音频生成口型同步视频,同为开发者本地部署