D
DreamTalk
dreamtalk-project.github.io又名 DreamTalk、DreamTalk Framework
开源扩散模型说话头生成框架,由清华大学、阿里巴巴集团与华中科技大学提出,输入一张照片和一段音频即可生成口型同步、表情自然的说话视频,支持多语种与说话风格调节,需自行配置环境与权重,适合数字人方向研究者复现或在此基础上改模型。
工具英文
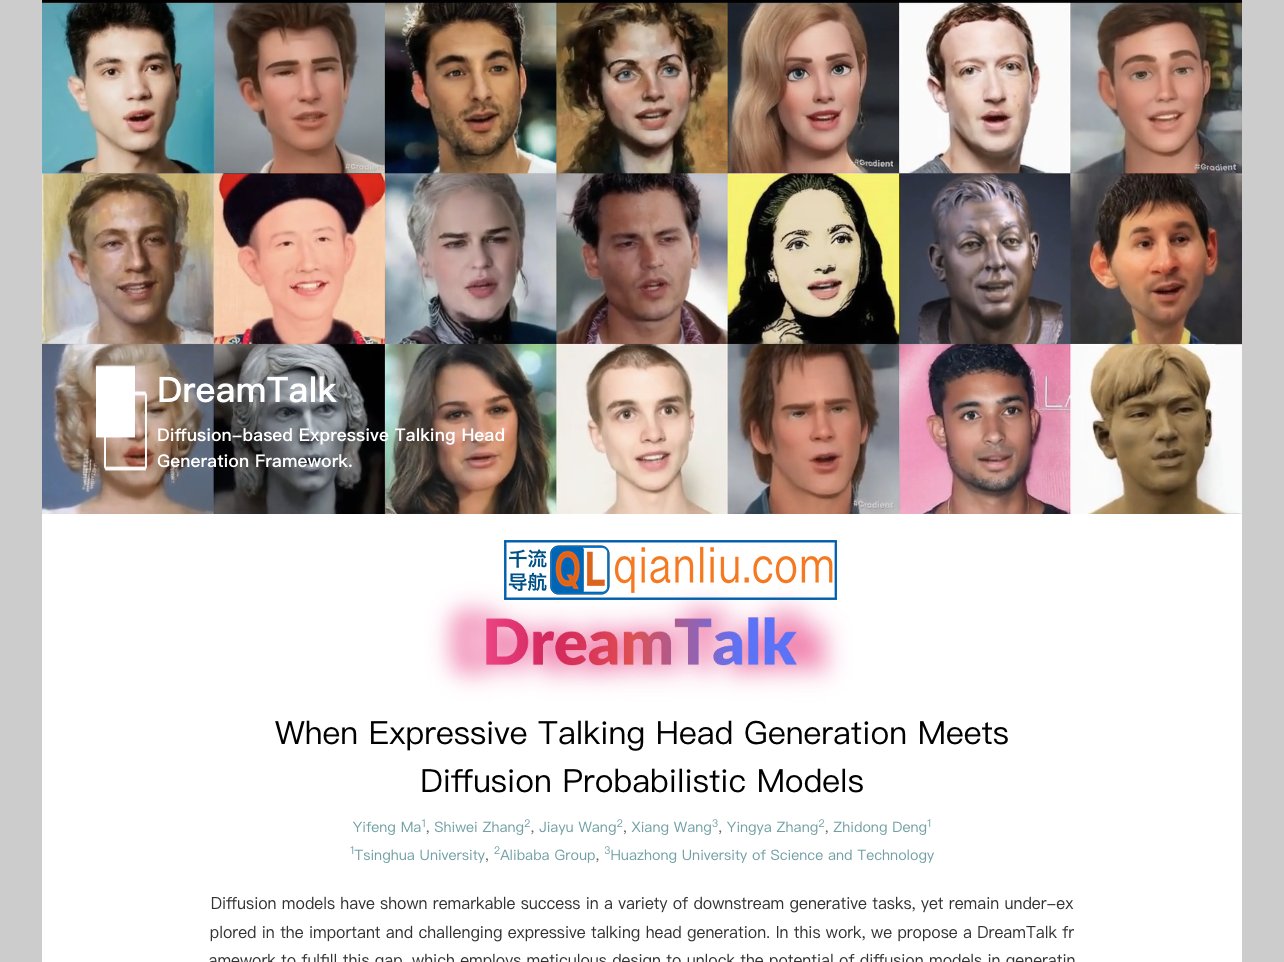
DreamTalk 是一个基于扩散模型的说话头生成框架,由清华大学、阿里巴巴集团和华中科技大学的研究者共同提出。它要解决的问题是:给定一张人物照片和一段音频,生成嘴型对得上、表情自然的说话视频。论文里把框架拆成三块——去噪网络负责音频驱动的人脸运动,风格感知唇部专家负责在照顾说话风格的同时对齐口型,风格预测器则直接从音频推断表情,省去额外录一段表情参考视频的麻烦。
主要能力
项目页展示的样例覆盖面不小:中文、英文、粤语、日文歌曲都能驱动,中文、法语、德语、意大利语、日语、韩语、西班牙语语音也在列;对训练分布之外的人像和带噪声的音频同样给出了演示。说话风格可以调,比如改无分类器引导的强度,或在风格编码之间做插值。
适合谁
适合做数字人、语音驱动动画方向的研究者和开发者。页面写明代码与模型权重已经放出,并附论文、代码、YouTube 演示三个入口,想复现或在此基础上改的人可以直接从仓库开始。
费用与限制
项目页没有提收费,属于学术开源项目,不涉及账号登录。实际使用需要自己准备运行环境、下载权重并处理推理,不是打开网页就能上传照片出片的在线工具;生成效果和速度取决于本地显卡。页面还挂着阿里巴巴的招聘信息,说明它同时是团队对外展示研究工作的窗口。
常见问题
DreamTalk 的替代品有哪些?
本站整理了 6 个替代品,例如 EchoMimic、OmniHuman-1、阿里云虚拟数字人、百度曦灵数字人平台。
替代品 全部 6 个 →
E
EchoMimic
蚂蚁集团支付宝终端技术部开源的肖像动画生成项目,可用音频、面部关键点或两者结合驱动静态人像生成口型与表情同步的视频,需自行配置环境、下载权重再推理,适合能跑模型的研究者与开发者。开源肖像动画项目,音频或关键点驱动人像,同样面向研究者本地部署
O
OmniHuman-1
字节跳动智能创作团队公布的人体视频生成研究项目,用单张人像配合音频、视频或两者组合驱动,生成说话、唱歌的动态人像,覆盖卡通形象与复杂姿态,适合数字人方向研究者对照方法、评估效果边界。替代音频驱动说话这一块:单张人像加音频即可生成说话唱歌视频,但非开源框架
 阿里云虚拟数字人
阿里云通义实验室的数字人平台,支持文本驱动视频合成、实时智能对话和 AIGC 直播推流,适合电商商家用数字人主播做 7×24 小时无人直播。替代生成说话视频这一块:云端出片省去配环境,但不开源、不可改模型
 百度曦灵数字人平台
百度智能云旗下的数字人平台,支持文生 3D、2D 定制和照片数字人,可克隆声音、按商品链接生成带货视频并做多语种唇形同步翻译,适合跨境电商和企业培训团队批量产出多语言视频。替代照片数字人出片这一块:多语种唇形同步在线生成,失去开源可改的自由
阿里云虚拟数字人
阿里云通义实验室的数字人平台,支持文本驱动视频合成、实时智能对话和 AIGC 直播推流,适合电商商家用数字人主播做 7×24 小时无人直播。替代生成说话视频这一块:云端出片省去配环境,但不开源、不可改模型
百度曦灵数字人平台
百度智能云旗下的数字人平台,支持文生 3D、2D 定制和照片数字人,可克隆声音、按商品链接生成带货视频并做多语种唇形同步翻译,适合跨境电商和企业培训团队批量产出多语言视频。替代照片数字人出片这一块:多语种唇形同步在线生成,失去开源可改的自由