O
OmniHuman-1
omnihuman-lab.github.io又名 OmniHuman
字节跳动智能创作团队公布的人体视频生成研究项目,用单张人像配合音频、视频或两者组合驱动,生成说话、唱歌的动态人像,覆盖卡通形象与复杂姿态,适合数字人方向研究者对照方法、评估效果边界。
网页英文
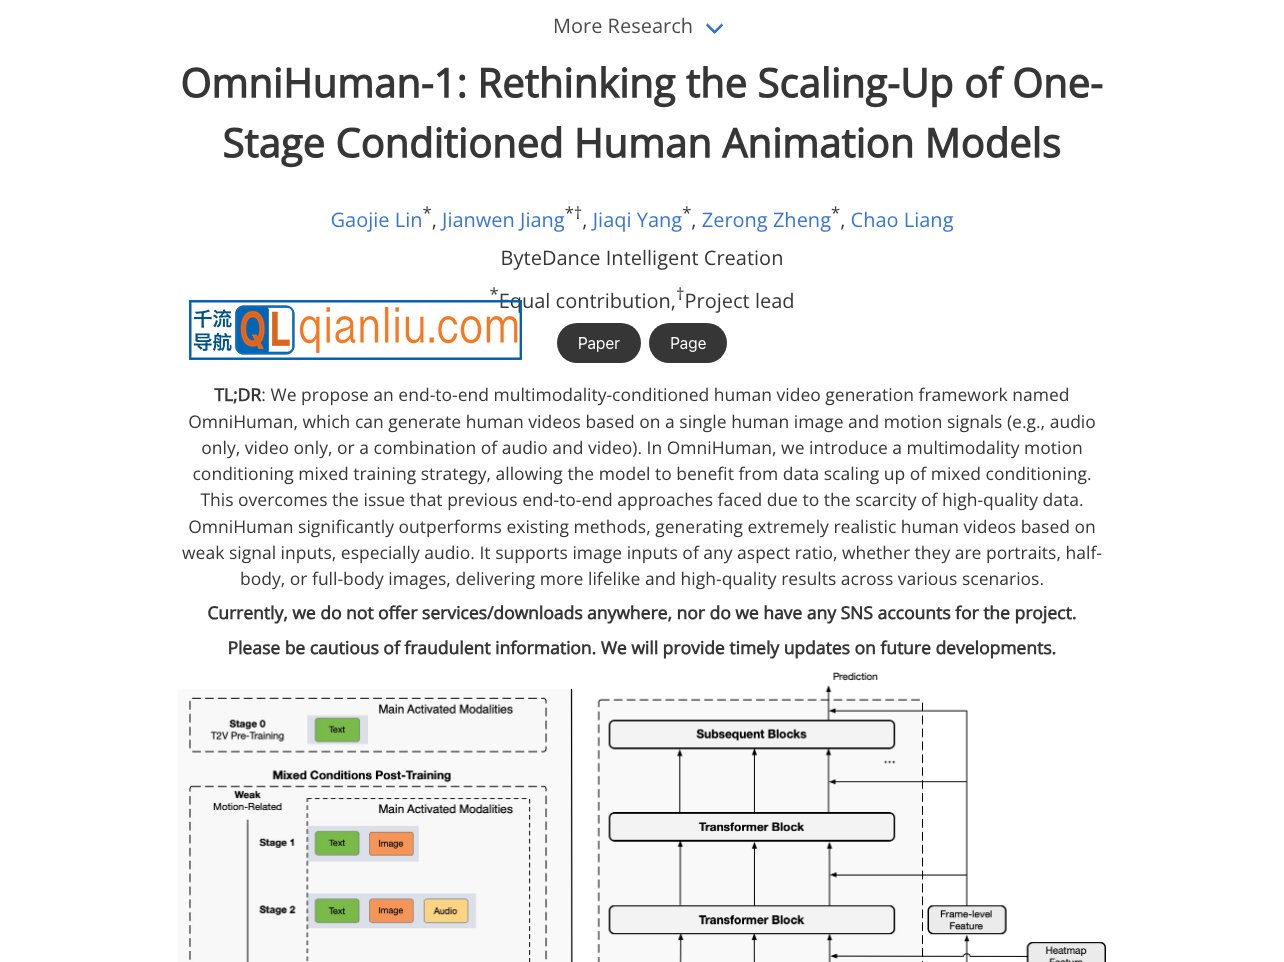
OmniHuman-1 是字节跳动智能创作团队(ByteDance Intelligent Creation)公布的一项研究项目,论文题为《Rethinking the Scaling-Up of One-Stage Conditioned Human Animation Models》。它要解决的问题是:给一张人物图片和一段运动信号,直接生成这个人动起来、说话或唱歌的视频。运动信号可以只有音频,也可以只有视频,或者两者组合。
能做什么
按项目页的演示,输入一张图片加一段音频,就能得到对应的人像视频,图片可以是肖像、半身或全身,横竖比例不限。演示覆盖了卡通形象、动物、人造物件和较难的姿势,也专门展示了唱歌场景,能处理高音和不同曲风的动作风格。除了音频驱动,它还支持用视频驱动来模仿特定动作,以及音视频联合驱动控制局部身体。
目前拿不到
项目页明确写着,目前不在任何地方提供服务或下载,也没有项目的社交账号,并提醒注意虚假信息。页面上只有论文、演示视频和 BibTeX 引用信息,没有可注册的入口,也没有客户端。想实际用上这套能力,眼下没有官方途径。
适合谁看
适合做数字人、音频驱动人像方向的研究者和工程团队,用来对照方法、看效果边界;普通用户想拿它做视频,暂时没有可操作的产品。页面也说明演示素材来自公开来源或模型生成,仅用于展示研究能力。
常见问题
OmniHuman-1 有哪些平台 / App?
支持 网页。
OmniHuman-1 的替代品有哪些?
本站整理了 5 个替代品,例如 OmniHuman AI、火山引擎虚拟数字人、商汤如影、AIGCPanel。
替代品 全部 5 个 →
 OmniHuman AI
使用 OmniHuman AI 创建逼真的数字人,并实现完美的唇形同步。将照片和音频转换为具有自然表情和动作的高质量数字人视频。替代照片加音频生成说话人像这一块:可直接上手出片,但没有卡通与复杂姿态的研究演示
 火山引擎虚拟数字人
字节跳动旗下火山引擎推出的一款创新技术产品,旨在通过人工智能和多模态技术,打造高度拟人化的虚拟形象,为用户提供智能化的交互服务同属字节系数字人能力,可实际调用做音视频驱动人像,但面向商用而非研究对照
 商汤如影
商汤科技的数字人内容创作平台,提供 100 多个版权形象和 300 多种音色,输入文字或录音即可合成口型自然的视频,也能复刻真人直播间做 24 小时带货和评论区智能问答,适合电商商家批量产出商品短视频与直播。替代音频驱动口播人像这一块:文字或录音即可合成,但缺少视频驱动与卡通形象演示
 AIGCPanel
开源的 AI 数字人桌面工作台,集成口型同步、音色克隆和 25 个以上音视频小工具,支持本地与云端模型,适合批量给客户出片的小团队和想二次开发的工程师。开源可本地部署,替代口型同步与音色克隆这一块,便于研究者自行实验,非官方模型