
FunASR
ModelScope 维护的开源语音识别工具包,把 ASR、VAD、加标点与说话人分离打包在一起,支持流式识别和 OpenAI 兼容接口,适合需要私有部署转写、做会议记录或字幕流水线的工程团队。
1 次可以打开平均 6.4 秒11 月 16 日 起国内不可直接访问11 月 10 日 起国内不可直接访问
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。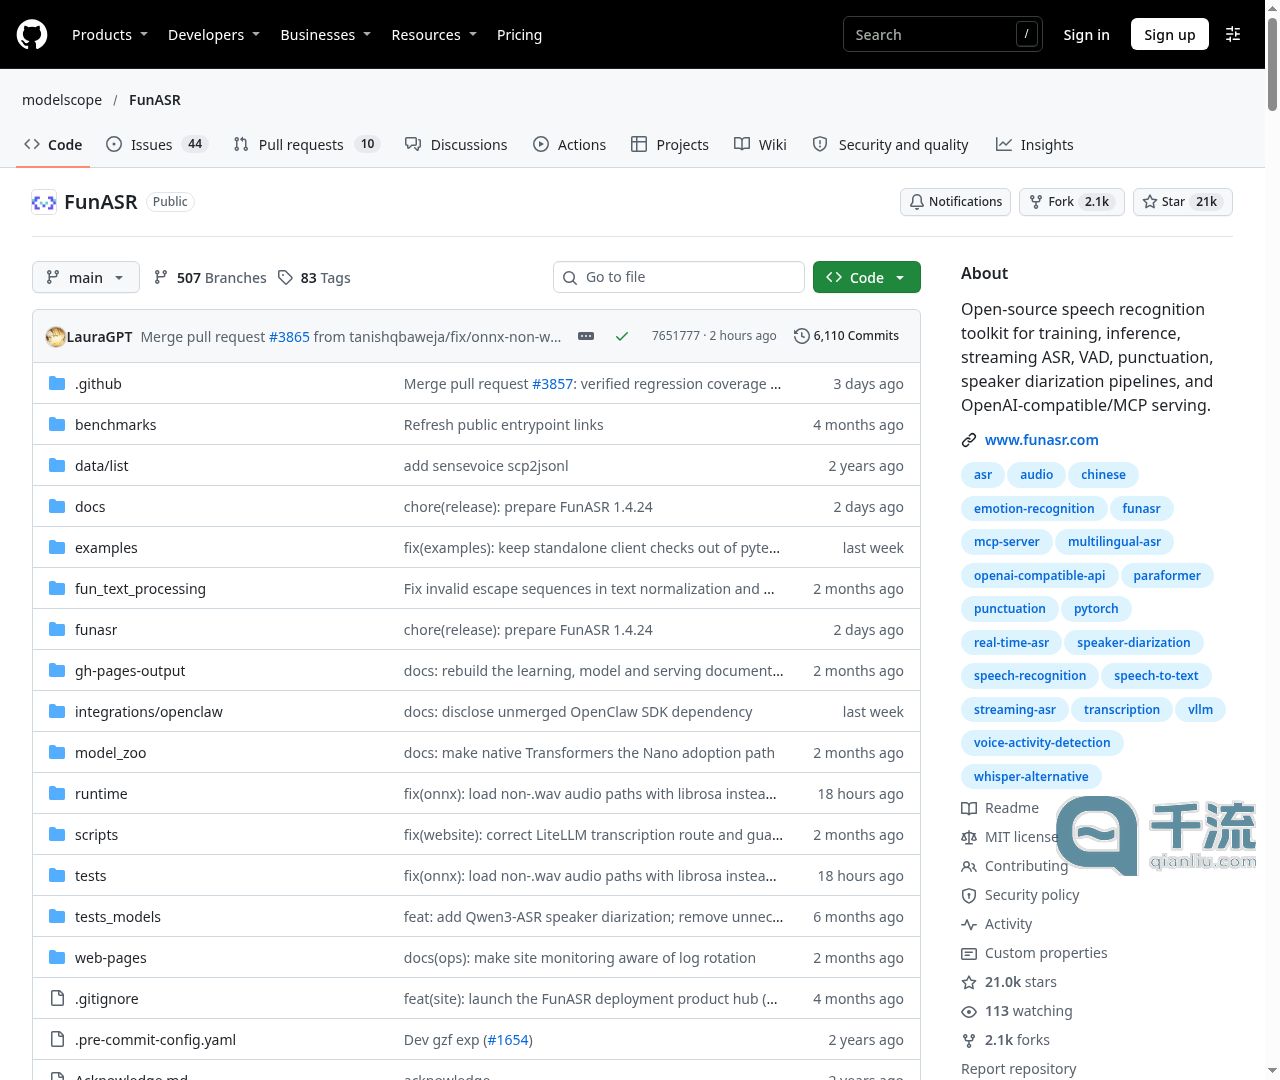
FunASR 是 ModelScope 团队维护的开源语音识别工具包,把语音转文字这条链路上的几件事打包在一起:识别(ASR)、语音端点检测(VAD)、加标点、说话人分离,还有情绪识别和音频事件模型。它面向的是要自己搭转写服务的开发者,而不是想打开网页就上传音频的普通用户。
主要功能
安装走 Python 包,先装 torch 和 torchaudio,再 pip install funasr,之后用 AutoModel 指定模型名就能对一段音频做识别,返回结果里直接带文本。除了离线整段转写,它也支持流式识别,适合边说话边出字的场景。仓库里还给了 OpenAI 兼容 API 的示例和 OpenAPI 规范,方便把它接到已有的接口体系里;另有 MCP 服务的相关说明。
模型按 checkpoint 区分语言覆盖,比如 Fun-ASR-Nano 覆盖中文、英文、日语及中文方言口音,另有一个 31 语言的 MLT 版本,两者要当成不同的模型对待。仓库里带 model_zoo 和 benchmark,选模型前可以先看对比。
适合谁
需要私有部署语音转写、做会议记录或字幕流水线的工程团队;研究语音识别、想拿现成模型微调的人;以及想把 ASR 能力包成 OpenAI 风格接口对外提供的后端开发者。只想转写一段录音的话,用它的 Colab 示例或 Hugging Face 上的 Transformers 路径更省事,不必装整套工具包。
费用与限制
代码以 MIT 协议开源,模型另有单独的许可协议,商用前要读一遍 MODEL_LICENSE。GPU 推理需要装与驱动匹配的 CUDA 版 PyTorch,装错了会退回 CPU 跑。文档站有中英日韩多语言版本,仓库 README 也提供简体中文。
常见问题
FunASR 收费吗?
用 FunASR 要登录吗?
FunASR 有哪些平台 / App?
替代品全部 12 个,带对比表 →
 WhisperX可完全替代开源可自部署,词级时间戳对齐和说话人分离比 FunASR 更成熟,但流式识别和 OpenAI 兼容接口要自己补。
 ESPnet可完全替代开源可自部署,ASR 之外还带合成、翻译、增强,配方和预训练模型多,但流式与 OpenAI 接口需自行搭建。
 Amazon Transcribe可完全替代换成云端 API 免运维,自带标点、说话人识别和脱敏,但失去私有部署和开源,按量计费。
 Whisper部分替代替代识别与多语种转写这一块:模型生态更成熟,但缺 VAD、标点和说话人分离的打包链路
 whisper.cpp部分替代替代离线部署这一块:纯 C/C++ 不依赖 Python,可嵌进端侧,功能面比 FunASR 窄
 录音转文字助手部分替代替代网页端快速转写这一块:上传即出稿,不用装 Python 环境,但没有流式识别和私有部署。