
ESPnet
基于 PyTorch 的开源端到端语音处理工具包,把语音识别、合成、翻译、增强等任务收在同一套代码里,配 Kaldi 风格配方和数百个预训练模型,命令行一行即可推理,适合语音方向研究者快速试模型或复现论文实验。
5 次可以打开平均 1.6 秒
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。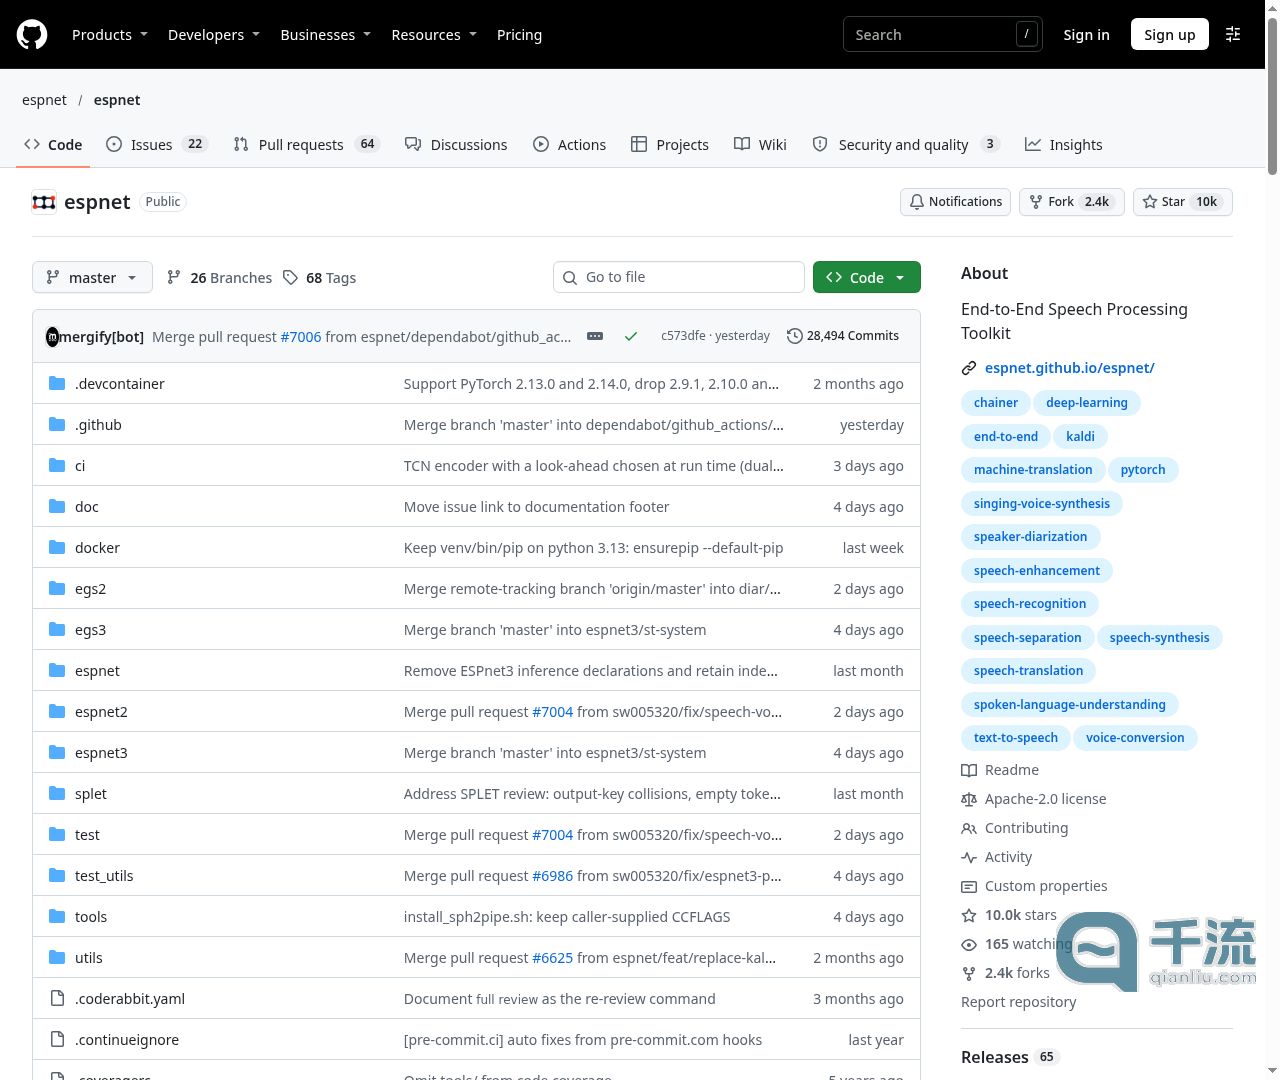
ESPnet 是一个跑在 PyTorch 上的端到端语音处理工具包。它把语音识别、语音合成、语音翻译、语音增强、说话人分离、口语理解、语种识别、歌声合成、语音语言模型这些任务收在同一套代码里,每个任务都配了 Kaldi 风格的处理流程,从数据准备一路走到评测,中间步骤可以照着配方复现。仓库里还挂着数百个预训练模型,放在 Hugging Face 上。
主要功能
命令行是它最近发力的地方。装好之后一行就能跑推理,比如把一段 wav 直接转成文字;命令行里还有 phonemize 读音素、align 把文本和音频对齐,asr 和 tts 两个子命令改名为 transcribe 和 synthesize,旧名字仍然可用。带麦克风的 --live 模式可以边说边转写。Docker 镜像 inference-cpu-latest 和 inference-gpu-latest 让人不装环境也能跑一个已发布的模型。
训练侧按任务分目录,egs2、egs3 下是各种数据集的配方,espnet2 和 espnet3 是模型与训练代码。新版本把训练依赖拆了出去,核心安装不再带整套训练栈,要训练得额外装 espnet[train]。
适合谁
做语音识别、语音合成、语音翻译的研究人员和工程师是主要用户。想快速试一个预训练模型的人,用命令行或 Docker 镜像就能出结果;要做完整实验、复现论文结果的人,则要熟悉它的配方结构和数据准备流程。仓库用 Apache-2.0 许可,代码可以改、可以商用。
使用前要知道
它是代码库不是成品软件,没有图形界面,装环境、下模型、跑脚本都得自己来。文档、安装说明、配方和模型库都在项目页面上,遇到问题主要靠文档和 Discord 社区。版本按年月发布,更新节奏比较快,接口偶有改名。


