
Text Generation Inference
Hugging Face 出品的大模型部署与推理工具包,支持张量并行、连续批处理与 token 流式输出,适合手里有 GPU、要把开源模型包装成可调用 API 的开发者。
4 次可以打开平均 2.9 秒11 月 19 日 起国内不可直接访问11 月 10 日 仓库已归档
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。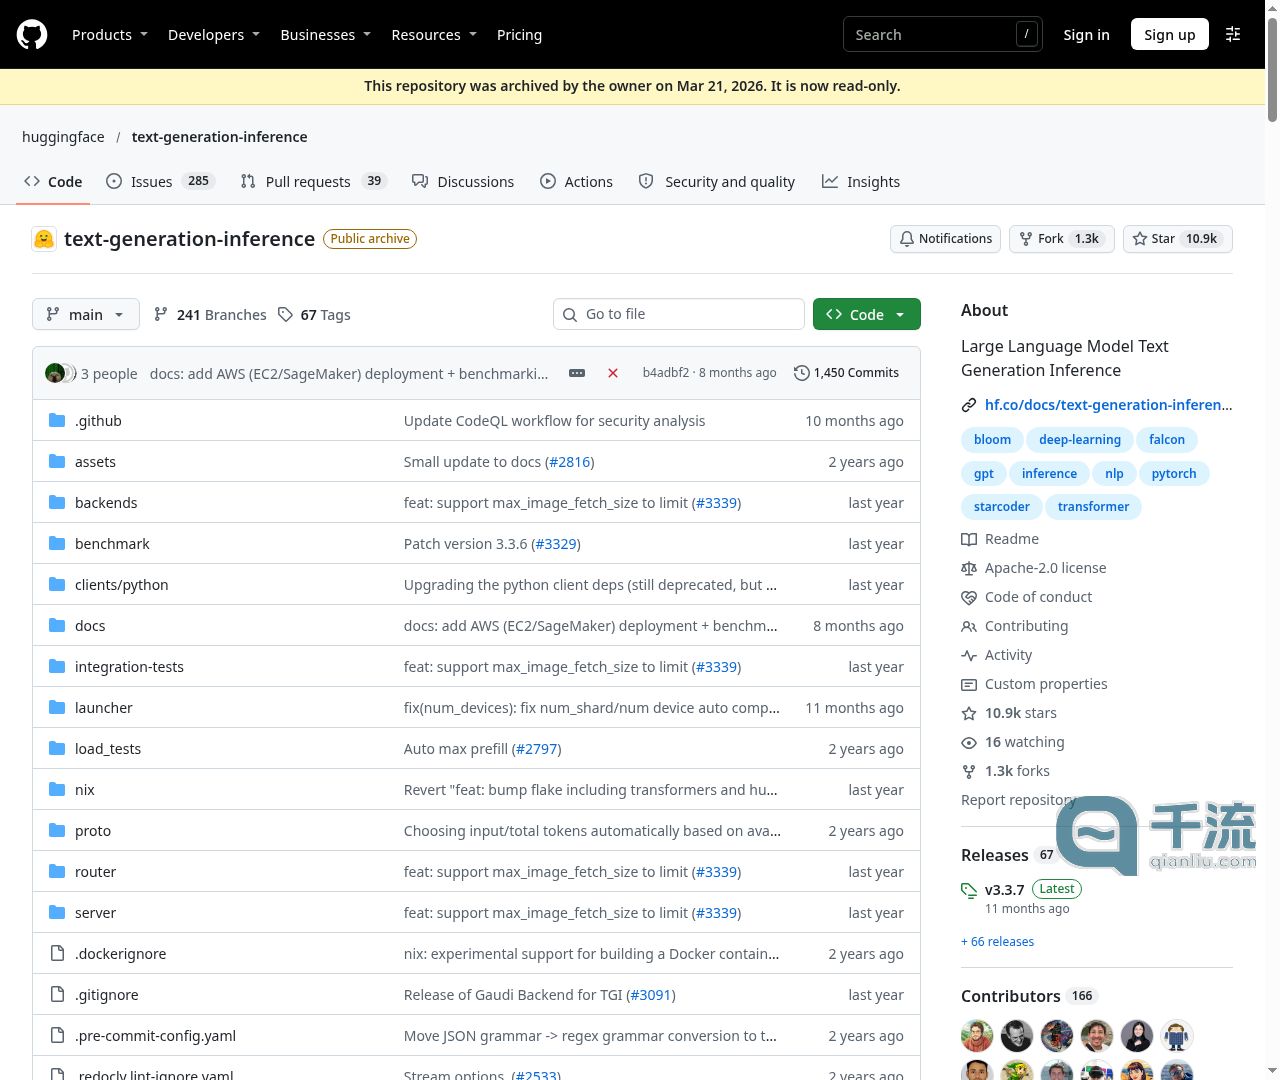
Text Generation Inference(简称 TGI)是 Hugging Face 做的一套大语言模型部署与推理工具包。它解决的是「模型训练好了,怎么稳定、高效地对外提供生成服务」这件事:把 Llama、Falcon、StarCoder、BLOOM、GPT-NeoX 这类开源模型跑起来,对外提供文本生成接口。Hugging Face 自己的 Hugging Chat、Inference API 和 Inference Endpoints 都用它支撑。
主要功能
它自带一个简单的启动器,多数主流开源模型填上名字就能起服务。面向生产的部分包括:用 OpenTelemetry 做分布式追踪、暴露 Prometheus 指标;多卡时用张量并行加快推理;用 Server-Sent Events 做 token 流式输出;对进来的请求做连续批处理以提高总吞吐。接口层面提供与 OpenAI Chat Completion 兼容的 Messages API,方便已有客户端直接切换。推理侧针对 Flash Attention、Paged Attention 做了优化,量化支持 bitsandbytes、GPT-Q、EETQ、AWQ、Marlin、fp8 等多种方案,权重用 Safetensors 加载,还带水印和 logits 处理等能力。
适合谁
主要给需要自己托管模型的开发者和运维团队:手里有 GPU 机器,想把开源模型包装成可调用的 API,或者要评估不同量化方案对吞吐的影响。它不是一个开箱即用的聊天网站,装好之后面对的是命令行、Docker 和接口文档。
现状与限制
仓库已在 2026 年 3 月 21 日被所有者归档,转为只读,项目进入维护模式,之后只接受小 bug 修复、文档改进和轻量维护类的 PR。官方在 README 里把优化推理的方向指向了 vLLM、SGLang,以及 llama.cpp、MLX 这类本地引擎。新项目选型时,这一点值得先考虑清楚。
常见问题
Text Generation Inference 收费吗?
用 Text Generation Inference 要登录吗?
Text Generation Inference 有哪些平台 / App?
替代品全部 7 个,带对比表 →
 vLLM可完全替代同为开源 LLM 推理服务引擎,PagedAttention 管显存、连续批处理与量化都覆盖,官方也建议新项目迁到它
 Xinference可完全替代同样兼容 OpenAI API,但一个平台还能跑嵌入、多模态和语音模型,不只 LLM。
 SGLang可完全替代同样自托管 GPU 服务,内置请求路由,但配置和运维方式与 TGI 不同。
 TensorRT-LLM可完全替代同为 GPU 推理优化,英伟达专用 kernel 更快,但只面向 NVIDIA 且需自己写运行时代码。
 Caffe部分替代替代模型部署这一块:配置文件定义网络、GPU 训练 CPU 部署,但面向视觉研究而非 LLM 推理。
 Hugging Face Inference Endpoints可完全替代不用自己管 GPU,Hub 模型一键部署成 API,但失去自托管和量化调优的自由。