
TensorRT-LLM
英伟达开源的 LLM 推理优化框架,用专用 kernel 和可编排 runtime 加速推理,提供 Python 接口定制模型并生成 Python/C++ 运行时,适合手里有 N 卡、要把模型部署成在线服务的工程团队压吞吐和延迟。
4 次可以打开平均 1.9 秒11 月 19 日 起国内不可直接访问
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。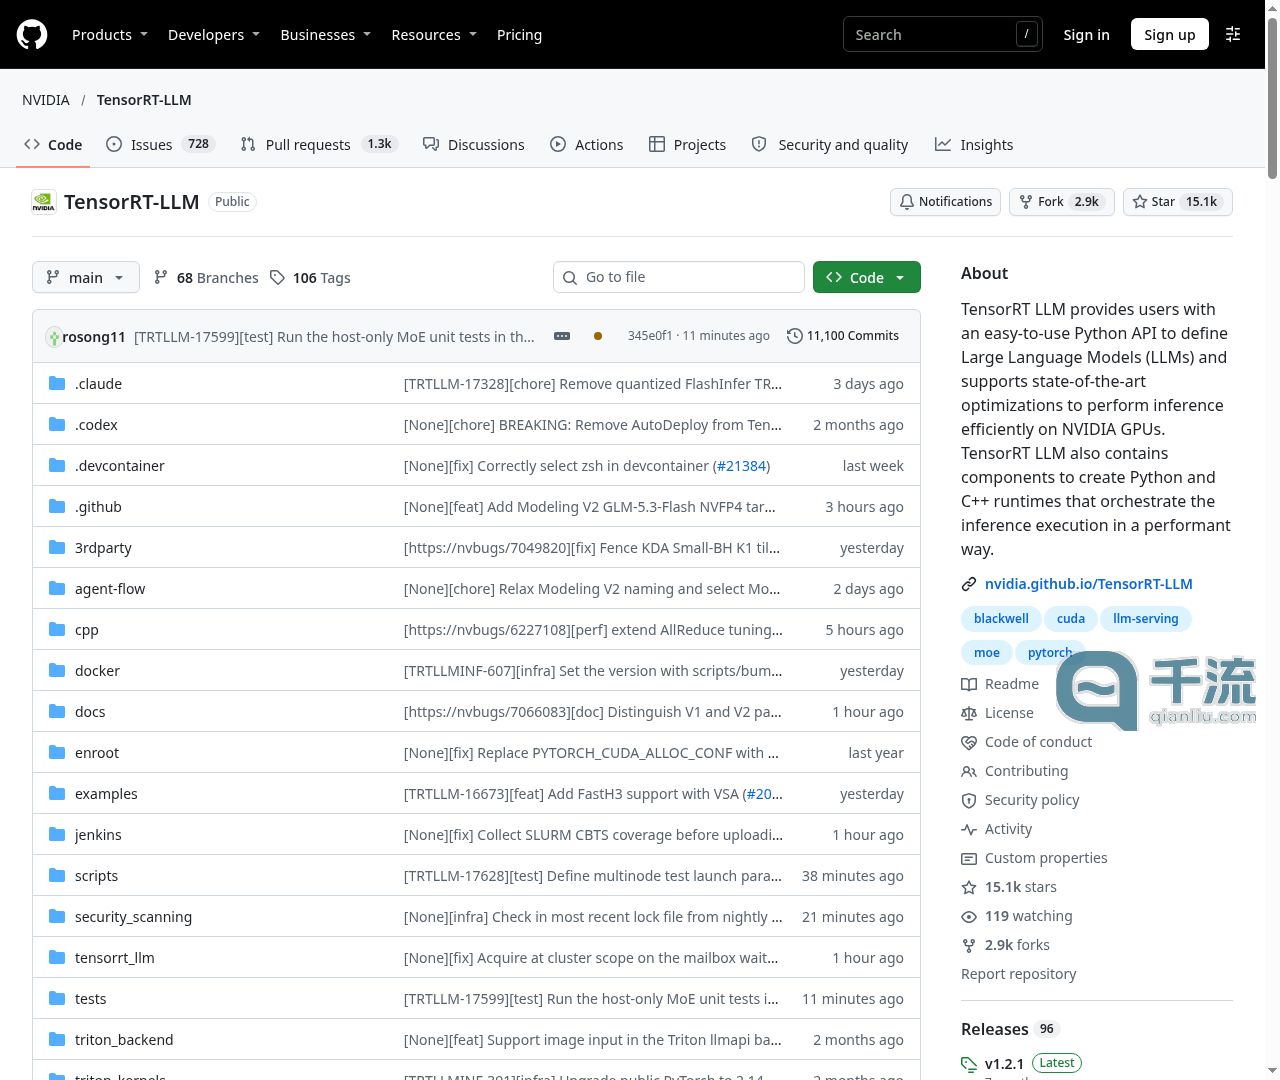
TensorRT-LLM 是英伟达在 GitHub 上开源的推理框架,解决的是「大模型训完了,怎么在自家 GPU 上跑得快、跑得省」这件事。它把常见的算子换成专门优化的内核,配一套高效的运行时,再用 Python 风格的接口让你改模型、加自定义逻辑。仓库里同时提供 Python 和 C++ 两种运行时的构建组件,方便把推理接进已有服务。
主要功能
核心是围绕 LLM 和视觉生成模型的推理优化:针对常见运算做专用 kernel,提供可编排的 runtime,以及一个能定制和扩展的 Python 框架。仓库 topics 里标了 blackwell、cuda、llm-serving、moe、pytorch,说明它覆盖新架构 GPU、模型服务、混合专家模型这些方向。文档站上有 LLM API 的快速上手,也有架构、性能、示例几块内容,技术博客会写具体的优化手段,比如 KV Cache 压缩、视频生成的量化加速。
适合谁
面向要把模型部署成在线服务的工程团队,尤其是手里有 NVIDIA 显卡、在意吞吐和延迟的人。它不是一个装好就能聊天的客户端,你得写代码、搭环境、按文档跑示例。只想本地试玩模型的话,这个仓库偏重了。
费用与限制
代码在 GitHub 上公开,仓库页面没有标价,使用本身不收费。它绑定 NVIDIA GPU,非 N 卡用不上;仓库界面是英文,文档也是英文。仓库有 15k star、2.9k fork,issue 和 PR 数量都不少,遇到问题可以先翻讨论区。
常见问题
TensorRT-LLM 收费吗?
用 TensorRT-LLM 要登录吗?
TensorRT-LLM 有哪些平台 / App?
替代品全部 5 个,带对比表 →
 vLLM可完全替代同为开源 LLM 推理服务引擎,PagedAttention 管 KV 缓存,支持连续批处理与量化,N 卡上可直接换
 SGLang可完全替代开源推理框架,内置请求调度,可部署 LLM 到 GPU 集群对外服务,覆盖压吞吐延迟的主场景
 Text Generation Inference可完全替代同样能把模型部署成 API 服务,但支持更多 GPU 品牌,不绑死 N 卡,吞吐优化不如 TensorRT-LLM 深。
 OpenLLM部分替代替代自托管部署这一块:一条命令起 OpenAI 兼容接口,但底层优化深度不如专用 kernel
 ONNX Runtime部分替代替代跨平台推理执行这一块:支持多硬件后端,但 LLM 专用 kernel 与调度不如本条