
MuseTalk
腾讯音乐 Lyra Lab 开源的音频驱动唇形同步模型,输入人脸视频和音频即可改嘴型对齐,支持中英日等多语,在 NVIDIA 显卡上可实时推理,适合有深度学习基础的开发者在本地给虚拟人视频配音。
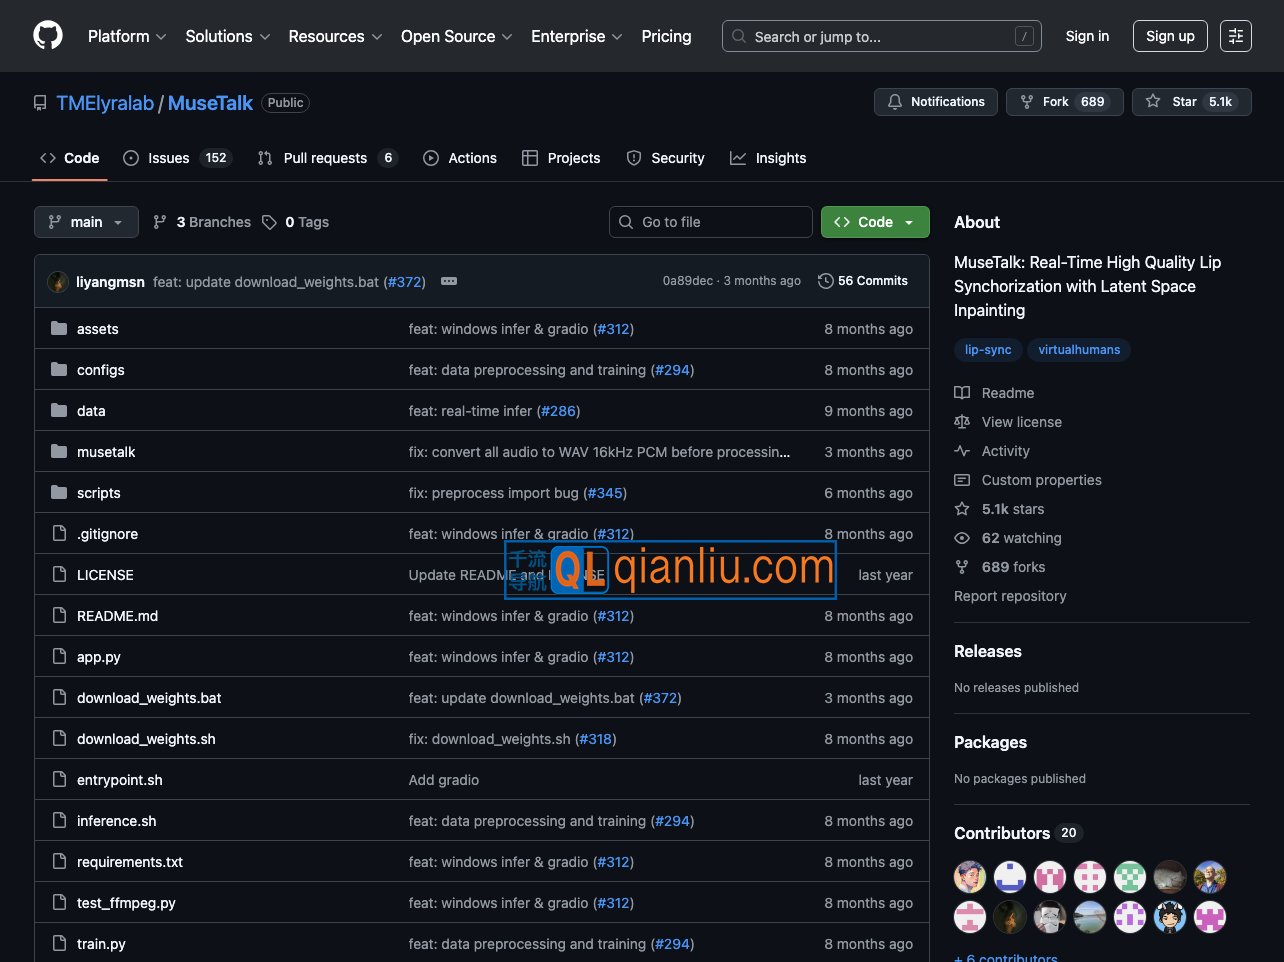
MuseTalk 是腾讯音乐娱乐(TME)旗下 Lyra Lab 开源的音频驱动唇形同步模型。给它一段人脸视频和一段音频,它会把视频里人物的嘴型改成跟音频对得上,脸的其他部分尽量保持原样。常见用法是给虚拟人视频配音、做多语言版本的口播,或者配合 MuseV 这类视频生成模型拼出完整的数字人流程。
主要能力
模型在 ft-mse-vae 的潜空间里训练,只处理 256×256 的人脸区域,音频用 whisper-tiny 编码后通过 cross-attention 融进 UNet。官方说明支持中文、英文、日文等多种语言的音频,在 NVIDIA Tesla V100 上能跑到 30fps 以上的实时推理。人脸区域的中心点可以手动调整,这个参数对最终效果影响明显。仓库里同时放了推理代码、训练代码和模型权重,1.5 版加入了感知损失、GAN 损失和同步损失,并采用两阶段训练和时空采样。
怎么用
这是给开发者用的仓库,不是点开就能用的网页工具。需要自己配环境、装依赖、下载权重(仓库里有 download_weights 脚本),再跑推理脚本或 app.py。仓库还提供 HuggingFace Space 上的 Gradio 演示,想先看效果可以从那里试。训练代码在 2025 年 4 月开源,有数据的话可以自己微调。
限制
实时推理依赖 NVIDIA 显卡,没有 GPU 基本跑不动。它只改嘴部区域,头部姿态、表情、光照都不会跟着音频变,输入视频质量差时效果会打折。仓库是英文 README,界面语言为英文,使用门槛偏向有深度学习基础的人。
常见问题
MuseTalk 收费吗?
用 MuseTalk 要登录吗?
MuseTalk 有哪些平台 / App?
MuseTalk 的替代品有哪些?
替代品 全部 5 个 →
 AIGCPanel
开源的 AI 数字人桌面工作台,集成口型同步、音色克隆和 25 个以上音视频小工具,支持本地与云端模型,适合批量给客户出片的小团队和想二次开发的工程师。替代本地口型同步这一块:开源桌面工作台集成口型同步,还带音色克隆等工具
O
OmniHuman-1
字节跳动智能创作团队公布的人体视频生成研究项目,用单张人像配合音频、视频或两者组合驱动,生成说话、唱歌的动态人像,覆盖卡通形象与复杂姿态,适合数字人方向研究者对照方法、评估效果边界。替代音频驱动人像这一块:单张人像配音频生成说话视频,但为研究项目非本地工具
 VASA-1
微软研究院的音频驱动人脸视频生成研究项目,输入单张照片和一段语音,实时生成口型与表情同步的说话视频,页面只提供论文与演示,适合做虚拟人、数字主播的研究者了解技术路线。替代音频驱动唇形这一块:单张照片加语音生成口型同步视频,仅提供论文与演示