
CogVideo
models.aminer.cn又名 CogVideo、CogVideo Demo
文本到视频生成预训练模型,94 亿参数,由 CogView2 迁移而来,采用多帧率分层训练,演示输出固定为 480×480、4 秒、8fps,适合想摸清早期文生视频能力边界的研究者试跑。
工具网页中文
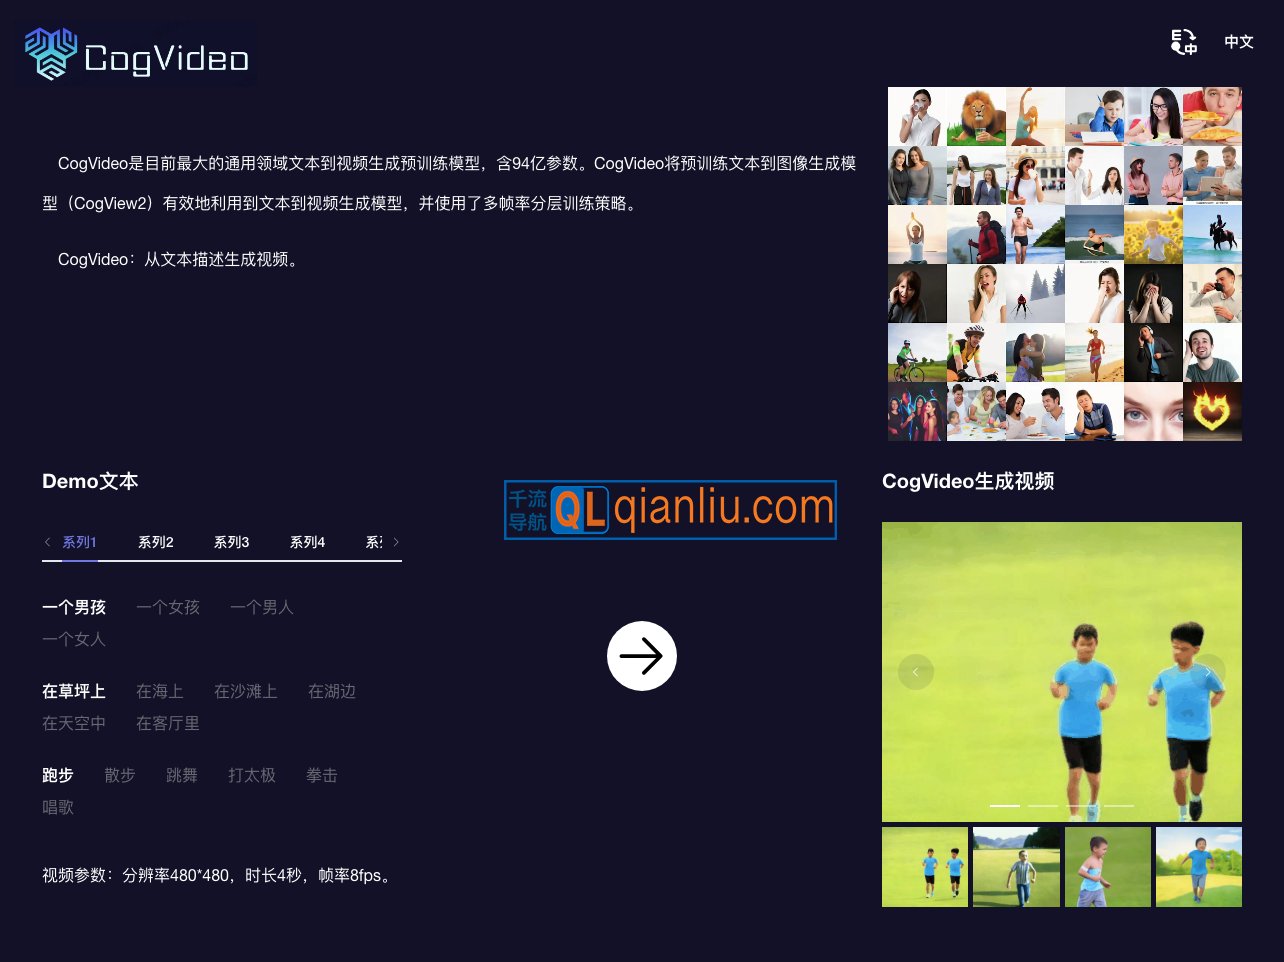
CogVideo 是一个文本到视频的生成模型,页面上称它是目前最大的通用领域文本到视频生成预训练模型,参数量 94 亿。它的做法是把已经训练好的文本到图像模型 CogView2 迁移到视频生成上,再配合多帧率分层训练策略,让模型学会从一句描述生成连续画面。
能生成什么
页面上的演示把提示词拆成几段:主体(一个男孩、一个女孩、一个女人等)、场景(草坪、海边、沙滩、客厅、天空)和动作(跑步、散步、跳舞、打太极、拳击、唱歌)。组合之后生成一段视频,参数固定为分辨率 480×480、时长 4 秒、帧率 8fps。也就是说,它输出的是低分辨率、短时长、帧率不高的片段,适合看效果、做实验,不是拿来直接剪片子的素材。
适合谁
对文本生成视频感兴趣的研究者、想了解早期文生视频模型能力边界的人,以及需要在自己的项目里试跑这类模型的开发者。普通用户如果只是想给文案配一段视频,这个演示页的规格和交互方式都不太够用。
使用前要知道
这是挂在 AMiner 模型站上的演示页面,不是完整的视频创作工具,页面上没有说明费用、账号和下载方式。演示的提示词是预设选项拼出来的,自由输入的空间有限。4 秒、8fps 的成片在流畅度和清晰度上都有明显限制,别按商用视频的标准去期待。
常见问题
CogVideo 有哪些平台 / App?
支持 网页。
CogVideo 的替代品有哪些?
本站整理了 3 个替代品,例如 Seedance、可灵AI、生数科技。
替代品 全部 3 个 →
 Seedance
字节跳动 Seed 团队推出的视频生成模型,支持文字或图片生成 1080p 视频,原生多镜头叙事能保持主体与风格连贯,运动表现和多种画风按指令响应,适合广告短片创作者把文字构想转成画面。替代文生视频这一块:能出 1080p 多镜头连贯视频,但闭源商用、不是可试跑的研究模型
 可灵AI
快手推出的 AI 创作平台,把视频生成、图片生成、数字人和创意特效放在同一工作台,支持参考素材与 @ 调用,适合营销运营人员快速产出短视频和广告素材。替代文本生成视频这一块:成片规格和可控性远超 480×480/4 秒,但为闭源创作平台而非预训练模型
 生数科技
做通用世界模型的公司,数字侧有视频生成模型 Vidu,物理侧有机器人动作模型 Motubrain,面向影视、广告、电商等内容生产方。替代文生视频这一块:Vidu 面向影视广告出片,规格更高,但不开源、无法像 CogVideo 那样研究模型