
Better Stack
面向开发与运维团队的可观测性平台,把日志、指标、链路追踪、错误上报和值班告警收进同一账号,链路追踪基于 eBPF 生成服务地图,适合服务出问题时在一个界面里排查根因并对外通告故障。
5 次可以打开平均 1.2 秒
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。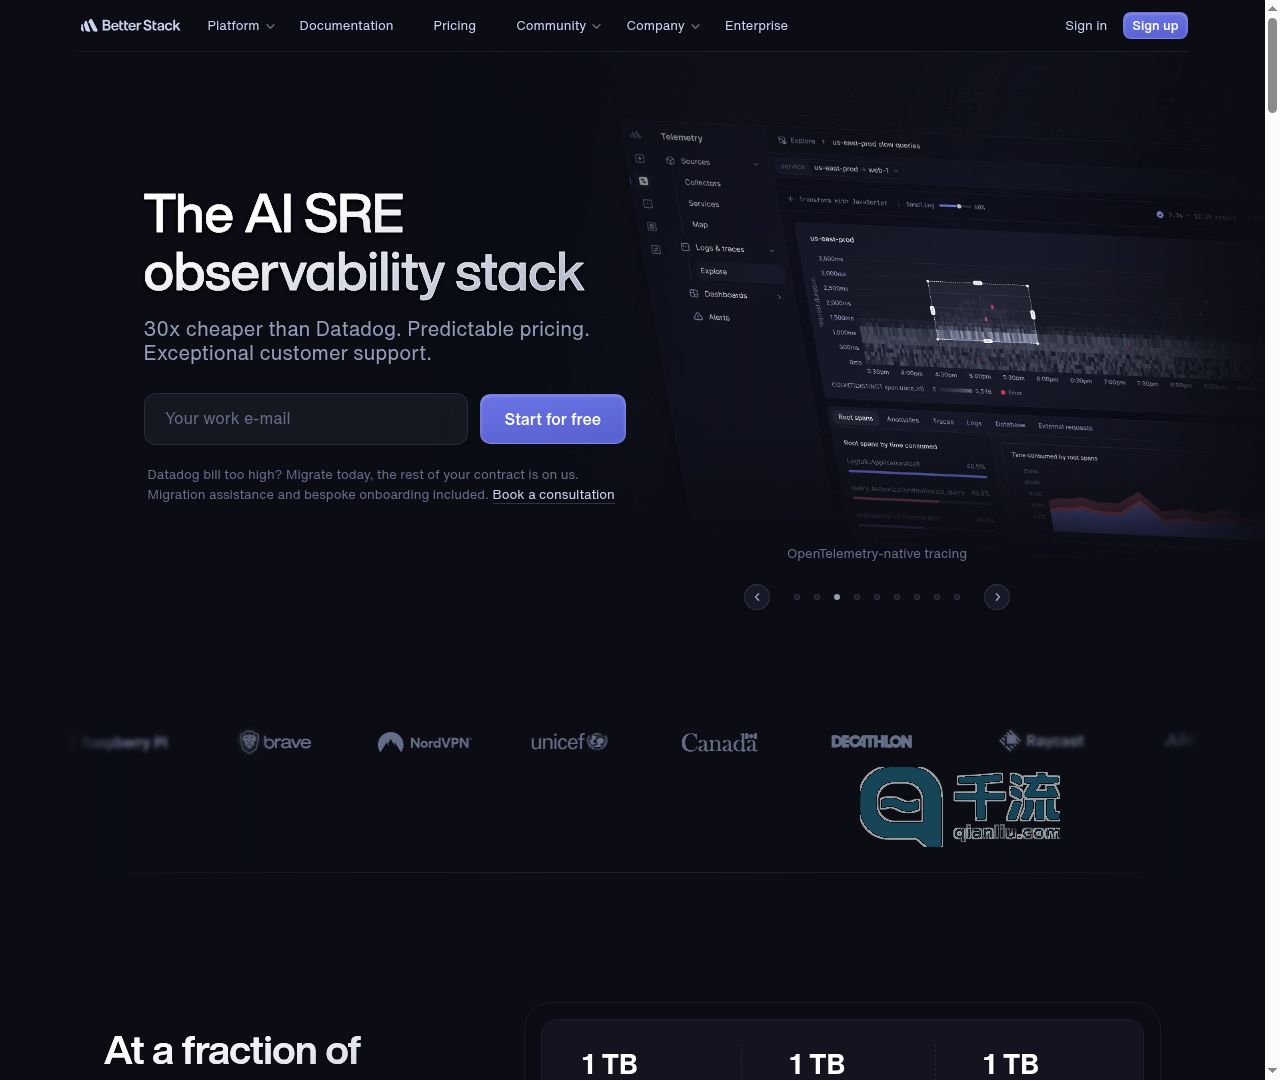
Better Stack 是一套给开发和运维团队用的可观测性平台。服务出问题时,排查通常要在日志、指标、链路追踪、错误上报、值班告警几个系统之间来回切换,它把这些收进同一个账号,再配一个对外状态页,用来告诉用户「现在是不是挂了」。
主要功能
日志、指标、链路追踪三块都按 OpenTelemetry 原生方式接入,链路追踪基于 eBPF 生成服务地图,能看到网络流向、自动给数据库打点,不用改代码就能给集群做埋点。错误追踪会记录出错时的 API 请求,支持通过 SQL over HTTP API 和 MCP server 查询数据。值班和事件管理在 Slack、Teams 里完成,同一时间冒出来的多条告警可以一键合并确认,事后由 AI 根据事件时间线和 Slack 记录生成复盘,还能一键建 Linear 工单。状态页用来对外通告故障。
AI SRE
页面主推的是 AI SRE:一个类似 Claude Code 的界面,带着你基础设施的上下文做根因分析,也提供 MCP server,把日志、指标、链路和错误接进已有的 LLM 工作流。官方强调人始终在决策环节里。
费用与限制
个人项目有免费档:10 个监控和心跳、1 个状态页、每月 10 万条异常、5000 次会话回放,日志和链路各 3 GB 保留 3 天。付费从每月 29 美元起(按年付),含一名响应人、不限团队成员,电话和短信告警不限量;提供 60 天退款保证。官网拿 1 TB 日志、1 TB 链路、1 TB 指标做对比,Datadog 约 56774 美元/月,Better Stack 为 687 美元/月,这个数字是官方估算,按年付、欧洲数据中心等条件计算。界面为英文,需注册账号使用。
常见问题
Better Stack 收费吗?
用 Better Stack 要登录吗?
Better Stack 有哪些平台 / App?
替代品全部 12 个,带对比表 →
 Datadog可完全替代多云容器架构下仪表盘和告警到调用链更成熟,但价格远高于本条,官方估算差几十倍。
 Grafana Cloud可完全替代日志、指标、链路与告警一体,开源可自部署,状态页需另配。
 Apache SkyWalking可完全替代开源可自部署,服务拓扑、链路、指标、日志和告警一次排查,但需自己运维、无托管状态页。
 Elastic Observability可完全替代日志、指标、链路统一到一处并用 AI 辅助根因,但需自建 Elastic 集群,无内置值班与状态页。
 DeepFlow可完全替代同样靠 eBPF 零侵扰采集并做全栈关联,可分钟级定界故障,但缺错误上报、值班告警和对外状态页。
 基调听云可完全替代服务端 APM 串起终端与拨测并支持 OpenTelemetry,国内可用,但值班告警和状态页需另配。