
Zipkin
开源的分布式追踪系统,采集服务间调用的耗时数据,支持按 trace ID 或服务名、操作名、标签筛选,并汇总各服务耗时与失败操作、画出依赖图,适合维护多服务系统的后端和运维人员排查跨服务调用延迟。
3 次可以打开平均 4.8 秒11 月 16 日 起国内不可直接访问
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。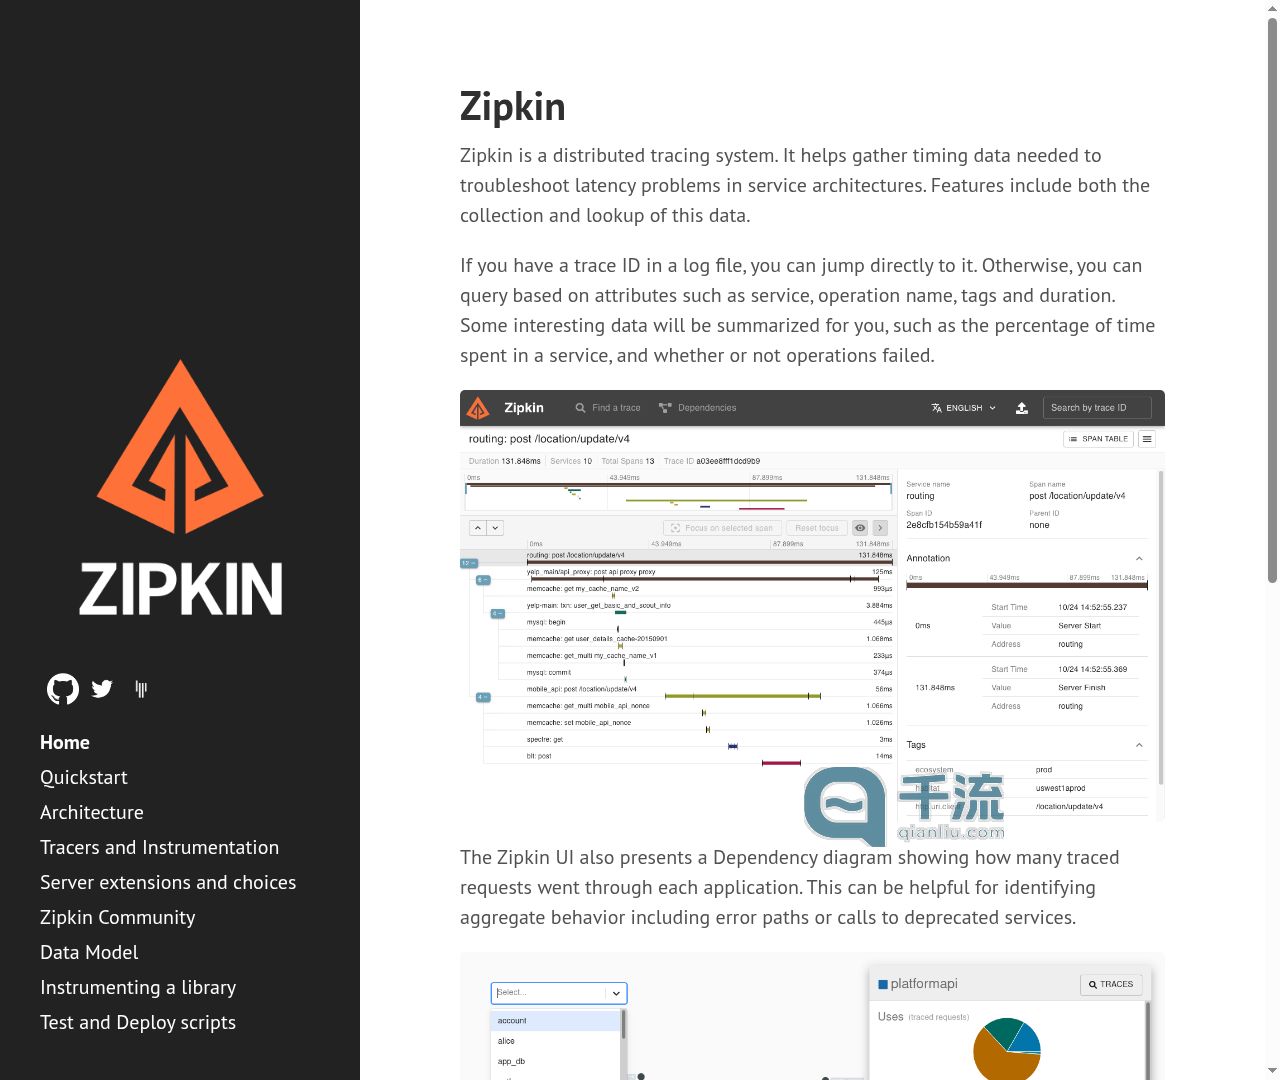
Zipkin 是一个分布式追踪系统,用来收集服务架构里各次调用的耗时数据,帮人定位延迟出在哪个环节。它既负责采集,也负责查询和展示。项目以 OpenZipkin 的名义开源,源码放在 GitHub 的 openzipkin/zipkin 仓库,问题也在那里跟踪。
能查到什么
日志里如果带着 trace ID,可以直接拿它跳到对应的那条链路;没有的话,就按服务名、操作名、标签、耗时这些属性去筛。查出来的结果会做汇总,比如某个服务占了多少时间、哪些操作失败了。界面里还有一张依赖图,显示有多少被追踪的请求经过了每个应用,用来观察整体行为,包括错误路径和对已弃用服务的调用。
数据怎么进来、存在哪
应用本身要先做「埋点」,也就是配置一个 tracer 或 instrumentation 库,才会把追踪数据报给 Zipkin。上报方式最常见的是 HTTP 和 Kafka,此外还有 Apache ActiveMQ、gRPC、RabbitMQ 等选择。界面读到的数据默认放在内存里,也可以持久化到 Apache Cassandra 或 Elasticsearch 这类受支持的后端。
适合谁
面向的是维护多服务系统的后端和运维人员,尤其是已经在用 Spring Cloud 一类技术栈、需要查跨服务调用链的团队。上手前可以先看 Quickstart,再确认自己的平台有没有现成的 tracer 或 instrumentation 库,以及是否需要服务端扩展或替代方案。社区交流走 Gitter 频道。


