Apache Impala
Apache 软件基金会旗下的开源分布式 SQL 查询引擎,直接对 Hadoop、Iceberg 等开放数据格式做低延迟 BI 查询,给数据平台和数仓团队用。
2 次可以打开平均 2.3 秒
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。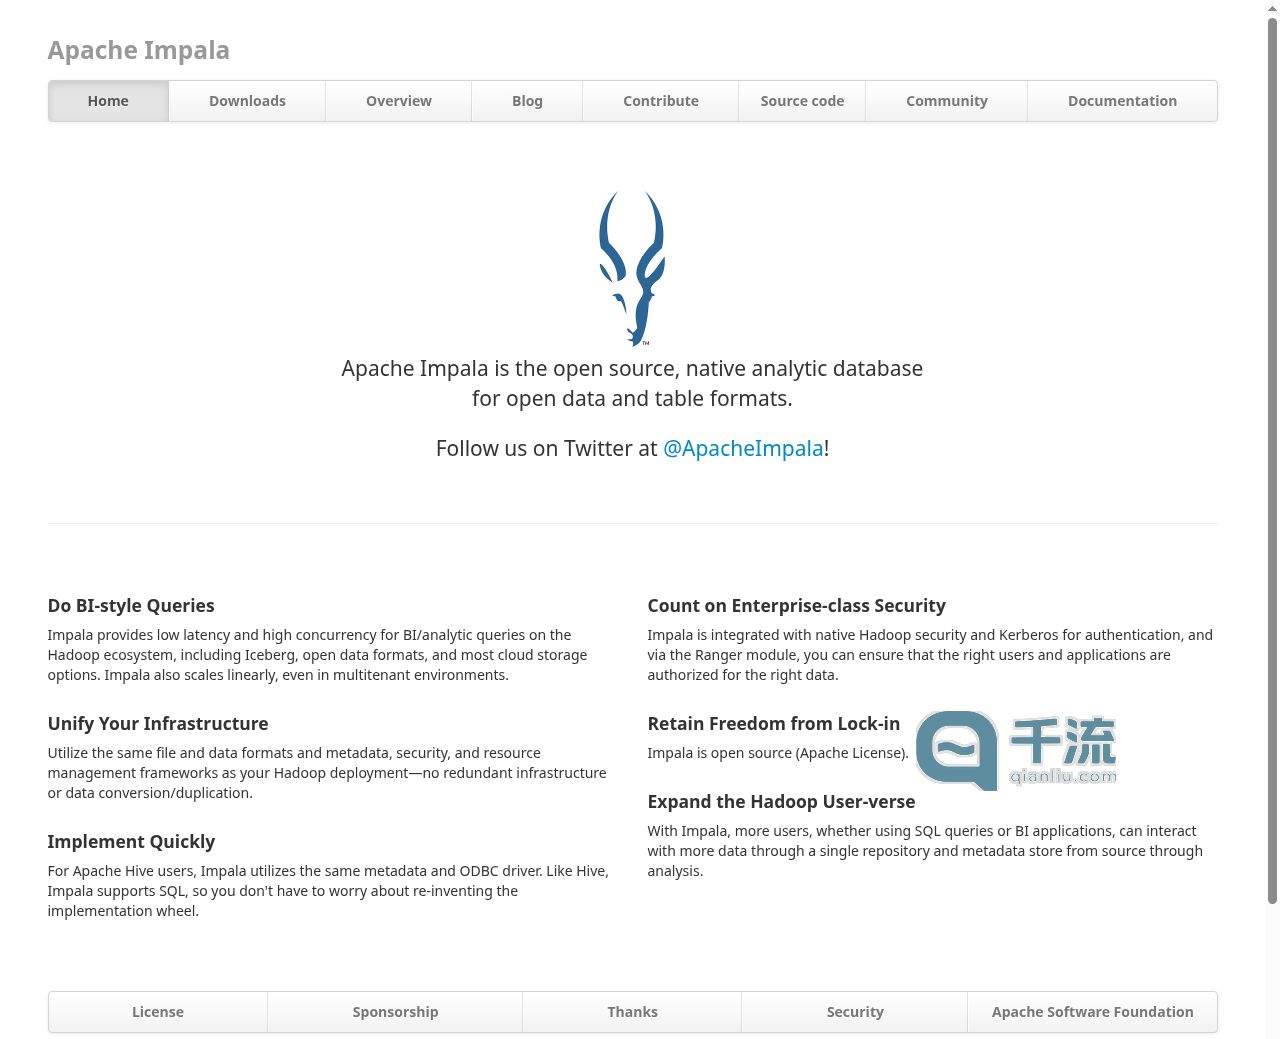
Apache Impala 是一个开源的分布式 SQL 查询引擎,定位是「面向开放数据与表格式的原生分析型数据库」。它跑在 Hadoop 生态之上,让用户用 SQL 或 BI 工具直接查询存放在 HDFS、云存储里的数据,不必先把数据搬进另一套系统。
主要能力
Impala 面向 BI 和分析型查询做了低延迟、高并发的设计,官方称即使多租户环境下也能线性扩展。它支持 Iceberg 等开放数据格式和多数云存储选项,与 Hadoop 部署共用同一套文件格式、元数据、安全和资源管理框架,因此不需要额外搭一套基础设施,也不用做数据转换或复制。
对已经在用 Apache Hive 的团队,Impala 复用相同的元数据和 ODBC 驱动,同样支持 SQL,迁移成本主要在部署和调优上,而不是重写查询。安全方面集成了 Hadoop 原生安全与 Kerberos 认证,并可通过 Ranger 模块做数据授权。
获取与版本
项目以 Apache License 2.0 发布,源码在官方仓库和 GitHub 镜像都能拿到。下载页当前列出 4.5.3 和 3.4.2 两个最新版本,提供带 SHA512 校验和 GPG 签名的源码包,DEB/RPM 包可从 GitHub Releases 下载;页面还附了在 Linux 和 Mac 上校验哈希与签名的命令。
适合谁
适合已经或准备在 Hadoop 体系上做数据分析的团队:数据平台工程师负责部署和调优,分析师和 BI 应用通过 SQL 或 ODBC 驱动接入。如果数据不在 Hadoop 生态里,或者只需要单机分析,这套东西就显得重了。
常见问题
Apache Impala 收费吗?
用 Apache Impala 要登录吗?
Apache Impala 有哪些平台 / App?
替代品全部 9 个,带对比表 →
 ClickHouse可完全替代同为开源列式OLAP,但脱离Hadoop生态独立部署,实时写入即可查,失去与Hive元数据共用。
 Apache Doris可完全替代开源MPP分析库,一个引擎兼顾OLAP与湖仓,省去Hadoop依赖,但需另建集群。
 Apache Druid可完全替代开源实时分析库,亚秒级查询高并发成本低,适合实时看板,但架构与Hadoop栈不同。
 Apache Kylin可完全替代开源OLAP靠预计算做亚秒查询,高并发多维分析强,但需建模预计算,不如即席灵活。
 Trino可完全替代开源分布式SQL引擎,直接查HDFS、S3并跨源联邦,交互式分析更灵活,但非MPP本地执行。
 Apache Hive部分替代替代元数据与SQL层:复用同一套Hive元数据和ODBC,但查询延迟高,不适合低延迟BI。