
faster-whisper
SYSTRAN 用 CTranslate2 重实现的 OpenAI Whisper 语音转文字库,速度最高提升 4 倍、占用内存更少,支持批量推理与 int8 量化,适合做会议记录、字幕生成的后端服务批量转写音频。
3 次可以打开平均 2.8 秒11 月 10 日 起国内不可直接访问
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。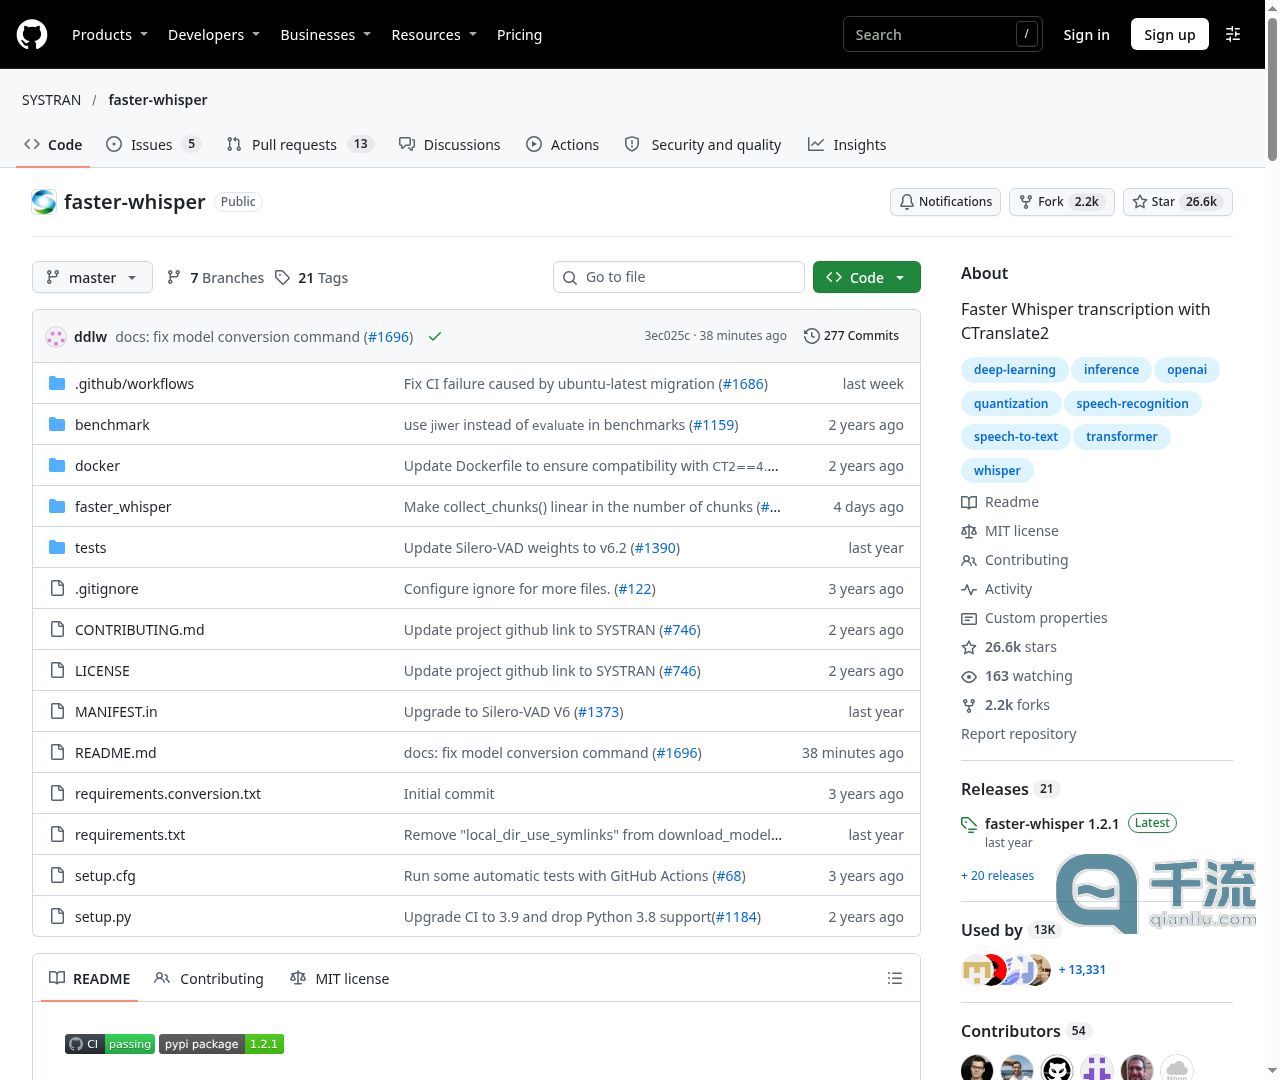
faster-whisper 是 SYSTRAN 团队用 CTranslate2 推理引擎重新实现的 OpenAI Whisper 语音识别模型。它解决的是原版 Whisper 跑起来慢、吃显存的问题:在保持相同识别精度的前提下,官方称速度最高可达 openai/whisper 的 4 倍,同时占用更少内存。项目以 Python 库的形式发布,不是开箱即用的桌面软件,需要写代码调用。
主要功能
核心能力是把音频转成文字,支持多种 Whisper 模型尺寸(从 small 到 large-v2 等)。它提供批量推理(batch_size 参数),在 GPU 上把 13 分钟音频的转写时间从单条处理的 1 分 03 秒压到 17 秒(fp16 精度、batch_size=8)。8 位量化(int8)在 CPU 和 GPU 上都能进一步提速并降低内存占用,比如 CPU 上 small 模型 int8 量化后只需 1 分 42 秒、1477MB 内存。
音频解码依赖 PyAV 库,它自带 FFmpeg 库,所以不像 openai-whisper 那样要求系统单独安装 FFmpeg。GPU 运行需要 NVIDIA 的 cuBLAS 和 cuDNN 9(对应 CUDA 12),旧版 CUDA 需要降级 ctranslate2 版本。
适合谁
适合需要批量转写音频、又对速度和显存敏感的开发者和团队,比如做会议记录、字幕生成、播客转文字的后端服务。项目页面上也提到了 Whisper-FastAPI 这类封装,方便直接起一个转写 API。普通用户如果只想把一段录音转成文字,用现成的转写工具会更省事。
费用与限制
项目采用 MIT 许可证,代码可自由使用和修改。运行环境要求 Python 3.9 或更高版本。GPU 加速需要搭配特定版本的 NVIDIA 库,环境配置有一定门槛;模型文件需要自行下载或转换。项目在 GitHub 上开源,有 26.6k 星标、2.2k 分支。
常见问题
faster-whisper 收费吗?
用 faster-whisper 要登录吗?
faster-whisper 有哪些平台 / App?
替代品全部 10 个,带对比表 →
 WhisperX可完全替代同为 Whisper 系开源库,额外带词级时间戳与说话人分离,批量转写场景可直接换
 whisper.cpp可完全替代整个换掉:纯 C/C++ 实现,不依赖 Python 和深度学习框架,可离线嵌进 App,但需要自己编译集成。
 TransPocket部分替代替代转写这一块:网页上传或贴 YouTube 链接,带说话人区分和 SRT 导出,不用写代码但只能手动逐个处理。
 蘑兔听记部分替代替代转写这一块:网页批量上传加实时录音,中文界面可边听边改,但转写在云端、不能自部署。
 录音转文字助手部分替代替代转写这一块:在线免费录音转文字,无需部署,但没有批量推理和量化提速,不适合后端服务。
 讯飞听见部分替代替代转写这一块:网页、App、小程序都能上传,1 小时音频最快 5 分钟出稿,但按服务收费且不能自部署。