
chineseocr_lite
开源轻量级中文 OCR 项目,检测、识别、方向分类三个模型合计约 4.7M,可在无显卡的普通电脑上离线运行,适合开发者把票据、证件、截图的文字提取接进本地脚本和批处理流程。
3 次可以打开平均 3.8 秒11 月 15 日 起国内不可直接访问11 月 8 日 起国内不可直接访问
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。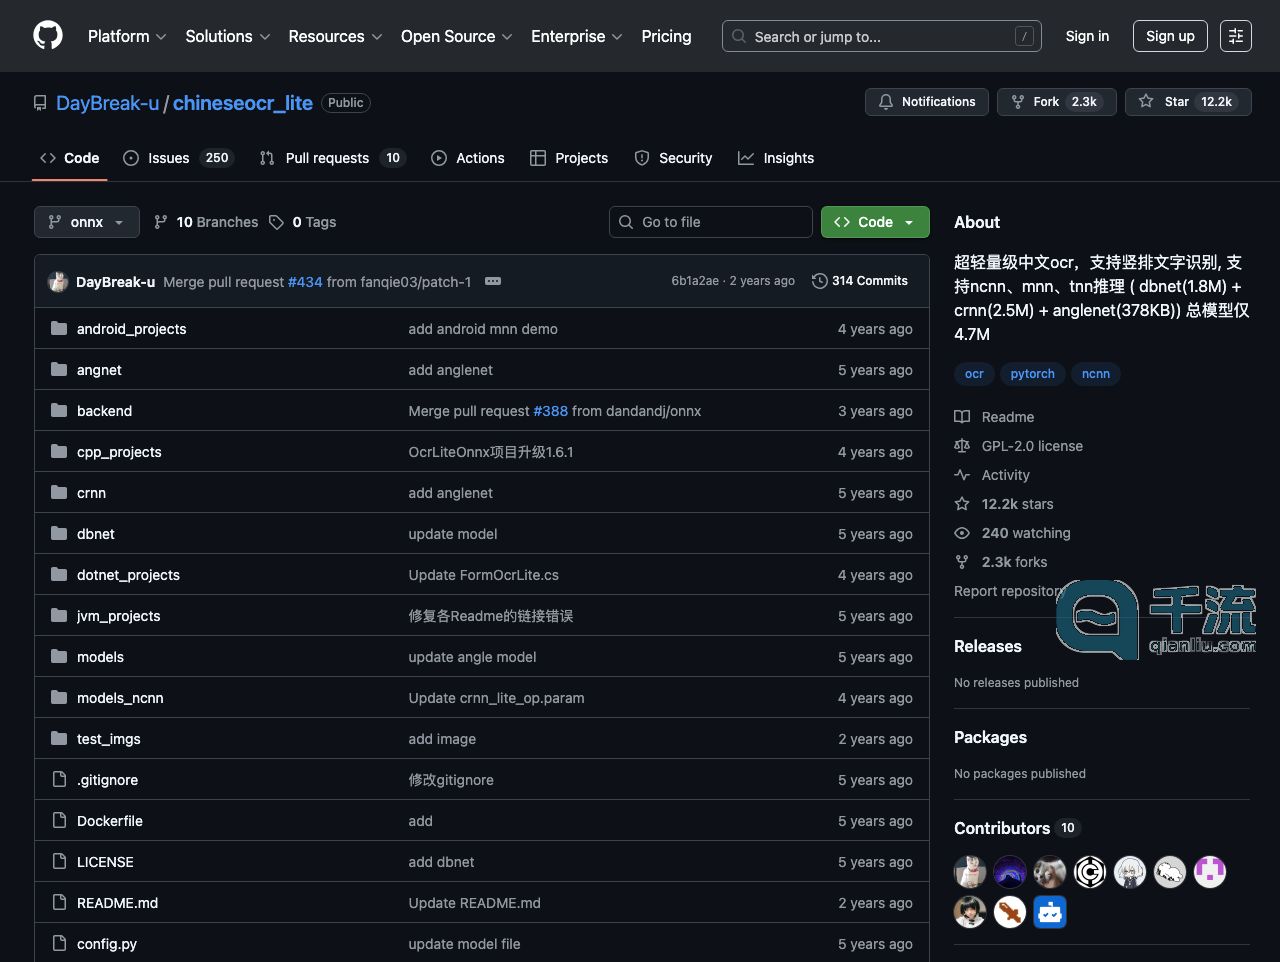
chineseocr_lite 是一个开源的中文 OCR 项目,仓库放在 GitHub 上,采用 GPL-2.0 许可。它把文字检测、文字识别和文字方向分类拆成三个小模型:dbnet 负责找出图里的文字框,crnn 负责把框里的字认出来,anglenet 判断文字朝向,三个加起来约 4.7M,因此能在没有显卡的普通电脑上跑。
主要功能
当前分支以 ONNX Runtime 推理为主,自带模型文件,装好依赖就能试。项目提供三种用法:启动 Tornado Web 服务后在浏览器里上传图片识别;用命令行 chineseocr 处理单张图片,输出带文字块坐标和置信度的 JSON,也可以加参数把检测框画到图上;或者作为 Python 模块调用。识别结果按文本块给出,每块带分数和四点坐标,方便脚本继续处理。
仓库里还有 C++、JVM、Android、.NET 多端参考 Demo,分别基于 ONNX Runtime、NCNN、MNN 等推理框架,其中 NCNN 版本带 CPU 和 Vulkan GPU 两种。这些 Demo 是各自独立的示例工程,不是开箱即用的成品 App。
适合谁
适合需要离线批量提取中文文字的开发者,比如做票据、证件、截图文字识别的本地工具,或者把 OCR 接进自己的脚本和批处理流程。项目说明里也提到 CLI 的 JSON 输出便于 agent 解析。只想找个网页传图识字的人,用它要自己装 Python 环境、跑服务,门槛偏高。
费用与限制
项目本身免费开源,代码和基础模型都在仓库里,不需要注册账号。推荐环境是 Python 3.6,Windows、Linux 或 macOS 均可,CPU 推理不需要 CUDA。Android 等端的完整源码工程需要到 QQ 群共享里下载。识别效果和速度取决于图片质量与机器性能,模型体积小,复杂版面的准确率不能和大型模型相比。
常见问题
chineseocr_lite 收费吗?
用 chineseocr_lite 要登录吗?
chineseocr_lite 有哪些平台 / App?
替代品全部 13 个,带对比表 →
 PaddleOCR可完全替代同为百度系开源中文 OCR,模型更全、文档解析更强,换过去识别能力不缺
 EasyOCR可完全替代同为开源离线 Python 库,装好即用支持多语言,但模型体积远超 4.7M,CPU 上更慢。
 MonkeyOCR可完全替代同为开源本地部署,能把文档转结构化文本,但走大模型路线,1.2B 体积远大于 4.7M。
 RapidOCR可完全替代基于 ONNXRuntime 的轻量 OCR,同样 CPU 离线跑,接口更简单、多语言封装齐全TTesseract.js可完全替代同为开源离线,可直接在浏览器和 Node.js 里跑,但中文识别弱于它,模型也更大。
 腾讯云文字识别部分替代替代高精度票据卡证识别:印刷体准确率更高,但要联网调 API、注册开户,不能离线自部署。