
Dask
开源的 Python 并行计算库,为 pandas、NumPy、Xarray 代码加上 .compute() 即可拆分任务到多核或集群,适合数据科学家在单机内存装不下时把原有分析脚本扩展上去跑。
4 次可以打开平均 3.7 秒
本站从国内机房定期实测。竖条由远及近:绿 = 可以打开,橙 = 国内不可直接访问,灰 = 打不开。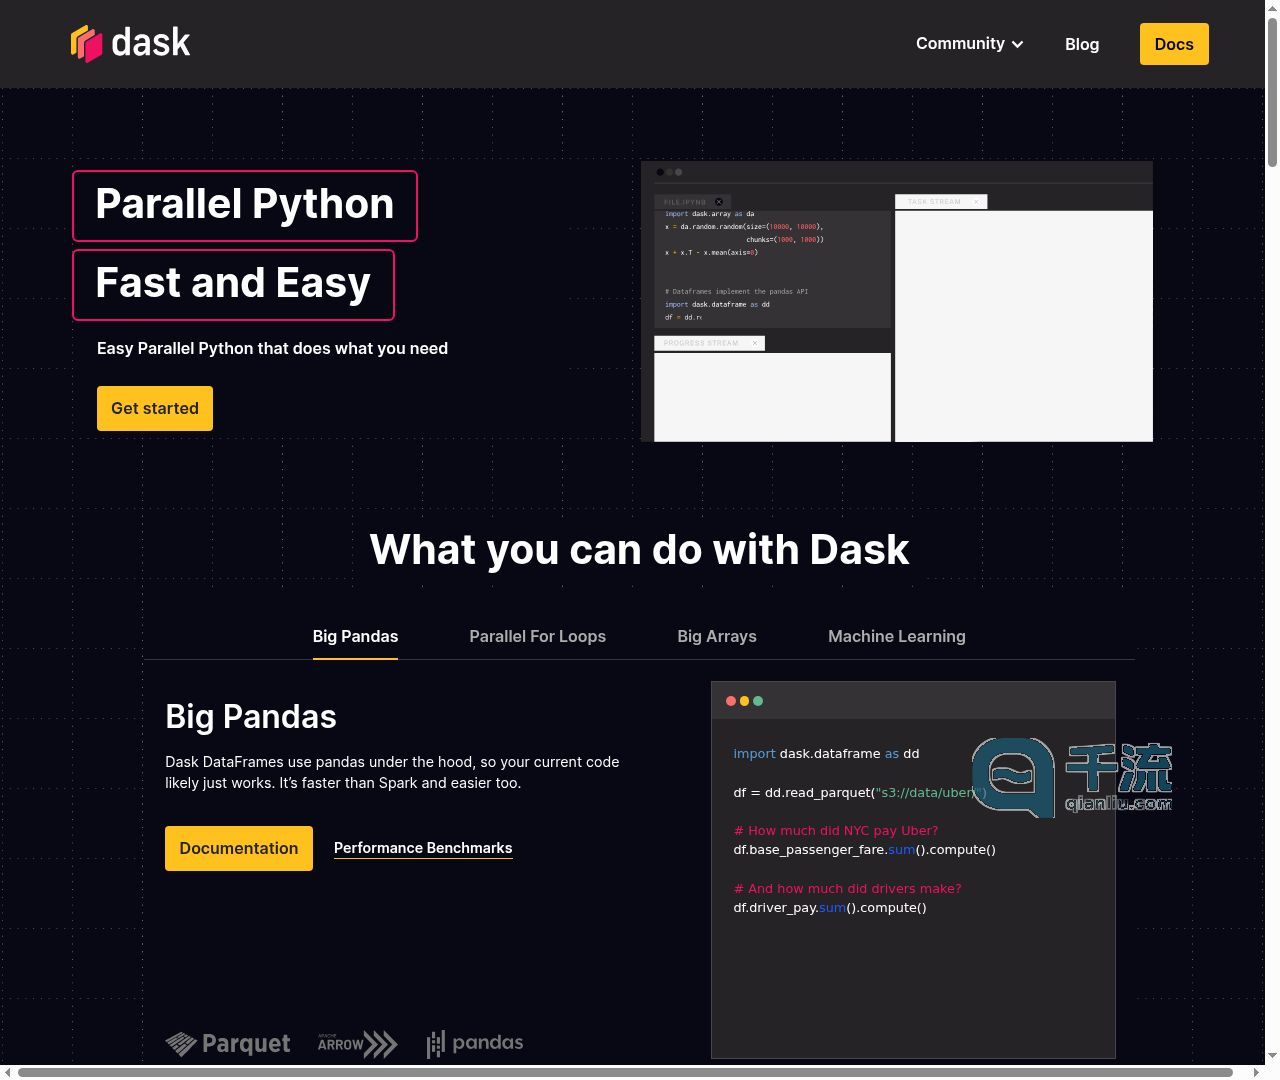
Dask 是一个开源的 Python 并行计算库,解决的是「代码在单机上跑得动,数据一大就跑不动」的问题。它把 pandas、NumPy、Xarray 这些熟悉的接口包了一层,原来的写法基本不用改,只要在最后加一个 .compute(),计算就会被拆成许多小任务,分到本机的多个进程或一整个集群上执行。
主要功能
Dask DataFrame 底层就是 pandas,读 Parquet 之类的文件时可以用通配符一次读入大量分片,再做筛选、分组求和;Dask Array 配合 NumPy 和 Xarray,处理 HDF、NetCDF、TIFF、Zarr 这类多维数组数据;此外还能把任意 Python 函数并行映射到一批输入上,任务之间的依赖关系可以很复杂。机器学习方面,页面给了用 XGBoost 在 Dask DataFrame 上训练的示例。
它自带一个 dashboard,跑任务时能看到各 worker 的负载和任务进度,用来判断瓶颈在哪。
运行方式
本地起一个 LocalCluster 就能用上多核;要上集群,可以部署在 Kubernetes、HPC 作业调度器、云服务甚至旧的 Hadoop/Spark 集群上。页面也提到托管方案 Coiled,个人小规模使用免费,有云账号即可开通。
费用与限制
库本身开源免费,页面称用户处理云端数据常见成本约为每 TiB 0.10 美元。它不提供虚拟化或编译器,直接在你的机器上跑原始 Python 代码,所以性能取决于代码本身和集群规模。页面宣称在标准基准上比 Spark 快 50%,这属于官方说法。文档和社区以英文为主。

